VIDEO NOTE
Mac Studio M5 Ultra와 DGX Spark 2대의 로컬 LLM 추론 성능 비교
Alex Ziskind · 20분 · 중급 · 26. 10. 03. · AI 초보 탈출 › LLM 원리 이해
 YouTube 에서 보기 · Alex Ziskind (새 탭에서 열림)
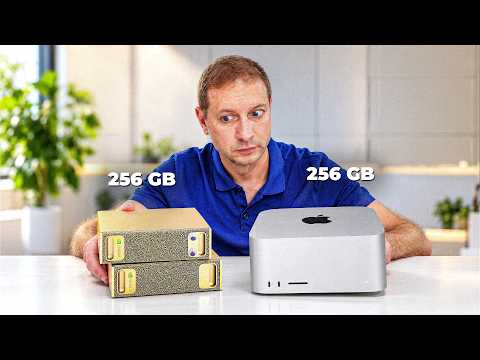
256GB 통합 메모리를 갖춘 Apple Mac Studio와 2대의 NVIDIA DGX Spark(총 256GB)를 연결한 클러스터에서 DeepSeek V4 Flash와 Qwen3.8 모델의 로컬 추론 성능을 비교했다. 프롬프트를 읽는 프리필 단계에서는 GPU 연산 성능이 뛰어난 DGX Spark가 2배 이상 빨랐으나, 토큰을 생성하는 디코드 단계에서는 높은 메모리 대역폭을 갖춘 Mac Studio가 대등하거나 앞섰다. 다중 사용자와 긴 컨텍스트 환경에서는 DGX Spark가 우세하지만, 단일 사용자의 KV 캐시 기반 작업에서는 Mac Studio도 충분한 실용성을 보였다.
핵심
- Mac Studio M5 Ultra(256GB 메모리)와 200Gb RoCE로 연결한 DGX Spark 2대(각 128GB, 총 256GB)의 성능을 비교했다.
- 연산 중심인 프리필(Prompt Processing) 단계에서는 DGX Spark가 Mac Studio보다 2~3배 빠르게 첫 토큰을 출력했다.
- 메모리 대역폭 중심인 디코드(Token Generation) 단계에서는 ~1TB/s 대역폭을 가진 Mac Studio가 DGX Spark(각 273GB/s)와 대등하거나 소폭 우세했다.
- 동일 세션에서 코드베이스를 KV 캐시에 올려두면 첫 턴 이후의 대기 시간 차이는 3초 대 1.4초 수준으로 크게 줄어들었다.
- 동시 접속자가 4~8명으로 늘어날수록 연산 성능이 우수한 DGX Spark 클러스터의 총 토큰 처리량이 더 높게 유지됐다.
- 풀 로드 상태의 전력 소비는 Mac Studio가 약 434W, DGX Spark 2대가 약 410W로 유사한 수준을 기록했다.
RAISE LAB 에서 배우는 사람에게
로컬에서 에이전트를 구동할 때 코드베이스 전체를 읽는 프리필 속도가 핵심 병목이 되므로, 대규모 컨텍스트를 자주 교체하는 환경이라면 GPU 연산력이 높은 구성이 유리하다.
챕터
- 0:00M5 Ultra와 DGX Spark 사양 비교 (새 탭에서 열림)
- 2:56텐서 병렬화와 vLLM 구동 구조 (새 탭에서 열림)
- 5:08프리필과 디코드 단계의 원리 (새 탭에서 열림)
- 6:10단일 사용자 토큰 생성 속도 측정 (새 탭에서 열림)
- 8:18프롬프트 길이에 따른 첫 토큰 대기 시간 (새 탭에서 열림)
- 11:09KV 캐싱이 실제 코딩 세션에 미치는 영향 (새 탭에서 열림)
- 13:54Apple MLX 프레임워크의 성능 차이 (새 탭에서 열림)
- 14:34다중 사용자 동시 접속 부하 테스트 (새 탭에서 열림)
- 18:18전력 소비와 발열 측정 비교 (새 탭에서 열림)
- 20:00작업 환경별 하드웨어 선택 가이드 (새 탭에서 열림)
이 노트는 RAISE LAB 운영팀이 고른 영상을 AI(Gemini)가 보고 한국어로 정리한 것입니다. 영상의 저작권은 원작자에게 있고, 자막·대본은 싣지 않습니다. Alex Ziskind 원작자 채널 (새 탭에서 열림)