VIDEO NOTE
DeepSeek-R1 논문 분석과 강화학습 기반 추론 모델 원리
Deep Learning with Yacine · 25분 · 고급 · 26. 11. 18. · 분야별 AX 사례 › 논문
 YouTube 에서 보기 · Deep Learning with Yacine (새 탭에서 열림)
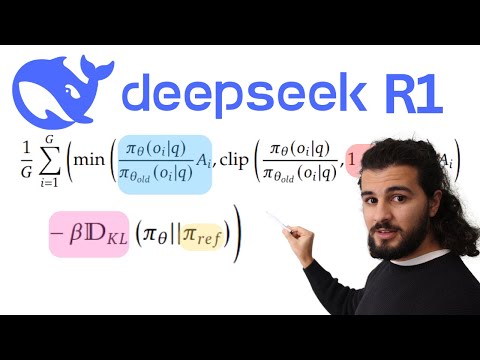
DeepSeek이 공개한 추론 모델 R1과 R1-Zero 논문의 훈련 파이프라인 전체를 다이어그램으로 상세히 짚어본다. 지도학습 없이 GRPO 강화학습만으로 자기 교정 능력을 유도한 R1-Zero의 구조와 수식을 살피고, 가독성과 언어 혼용 문제를 해결한 R1의 단계별 정제 방식을 설명한다. 대형 모델의 추론 체인을 Qwen과 Llama 기반 소형 모델로 지식 증류(Distillation)했을 때 강화학습을 직접 적용하는 것보다 성능이 우수하다는 점도 함께 다룬다.
핵심
- DeepSeek-R1은 사전 훈련된 671B(활성 37B) 매개변수의 DeepSeek-V3 Base 모델에 사후 훈련을 적용했다.
- R1-Zero는 지도학습(SFT) 없이 GRPO(Group Relative Policy Optimization)와 규칙 기반 보상만으로 OpenAI o1 수준의 추론 성능을 냈다.
- 규칙 기반 보상은 코드 컴파일 및 정답 일치 여부를 평가하는 정확도 보상과 <think> 태그 형식을 강제하는 포맷 보상으로 구성된다.
- 훈련이 진행됨에 따라 토큰 수가 늘어나며 모델이 스스로 오류를 수정하는 '아하 모먼트(aha moment)'가 자연스럽게 발현됐다.
- R1-Zero의 가독성 저하와 언어 혼용 문제를 극복하기 위해 R1은 수천 개 분량의 롱 CoT 콜드 스타트 데이터를 투입해 1차 SFT를 거쳤다.
- 중간 모델과 DeepSeek-V3를 활용해 60만 건의 추론 데이터와 20만 건의 비추론 데이터를 추출한 뒤 2차 SFT 및 다분야 강화학습을 수행했다.
- 소형 모델(Qwen 및 Llama)에 직접 강화학습을 거는 것보다 R1의 데이터를 바탕으로 지식 증류를 적용했을 때 벤치마크 결과가 뛰어났다.
RAISE LAB 에서 배우는 사람에게
복잡한 에이전트 시스템에 추론 모델을 통합할 때 거대 모델 직접 호출 외에도 R1 기반 오픈소스 증류 모델을 로컬 환경에 경량 배치하는 파이프라인 전략을 구상하는 데 도움이 된다.
챕터
- 0:00DeepSeek-R1 논문 개요 (새 탭에서 열림)
- 0:32전체 훈련 파이프라인 구조 (새 탭에서 열림)
- 0:53벤치마크 성능 비교 (새 탭에서 열림)
- 2:19R1-Zero와 순수 강화학습 (새 탭에서 열림)
- 5:00프롬프트 서식과 규칙 기반 보상 (새 탭에서 열림)
- 7:03GRPO 알고리즘 수식 분석 (새 탭에서 열림)
- 11:37사고 과정의 길이 증가와 아하 모먼트 (새 탭에서 열림)
- 14:30R1-Zero의 문제점과 콜드 스타트 데이터 (새 탭에서 열림)
- 17:00DeepSeek-R1 다단계 정제 파이프라인 (새 탭에서 열림)
- 19:42유용성과 무해성을 반영한 선호도 RL (새 탭에서 열림)
- 21:52소형 모델 지식 증류와 벤치마크 (새 탭에서 열림)
- 24:35핵심 요약 및 결론 (새 탭에서 열림)
이 노트는 RAISE LAB 운영팀이 고른 영상을 AI(Gemini)가 보고 한국어로 정리한 것입니다. 영상의 저작권은 원작자에게 있고, 자막·대본은 싣지 않습니다. Deep Learning with Yacine 원작자 채널 (새 탭에서 열림)